Met governance die standhoudt
AI-enablement voor testteams
Niet óf AI kan helpen bij testen, maar hoe je er controle over houdt.
Iedereen heeft het geprobeerd: een AI-assistent een test laten schrijven. Het resultaat is meestal een test die er goed uitziet en niet doet wat je denkt. Het probleem is niet de AI. Het probleem is dat hij niet kan zien wat er op het scherm gebeurt en dat niemand hem grenzen heeft gegeven.
Wij richten het anders in. Een agent die via een echte browser kijkt, klikt en bewijst wat hij deed. Die voorstellen doet in plaats van ongevraagd wijzigt. Die per schrijfactie goedkeuring vraagt en nooit zelfstandig iets destructiefs in je pijplijn aanstuurt. Dat is het verschil tussen een speeltje en een collega.
Vraag de pilot aan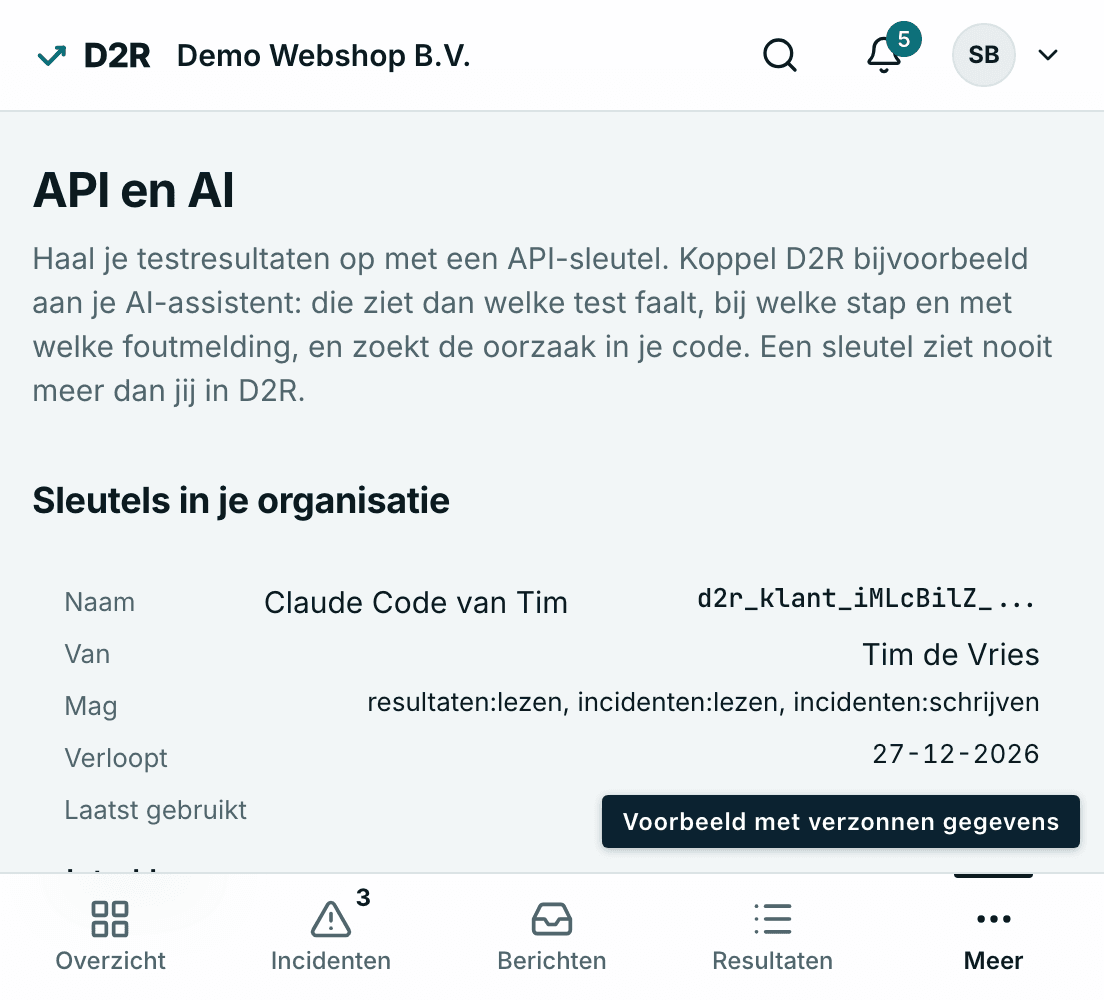
Voor wie
Voor testteams die verder willen dan experimenteren.
Dit past bij je als
Je team gebruikt al AI-hulpmiddelen, maar zonder afspraken.
Security of QA-management houdt AI tegen omdat de controle ontbreekt.
Je wilt sneller tests en bewijs, zonder dat de kwaliteit wegzakt.
Je werkt in een sector waar je moet kunnen aantonen wat er getest is.
Hoe het werkt
Een pilot van twee tot drie weken, in jouw omgeving.
MCP en agent-workflows opzetten
In jouw omgeving, op jouw software. De agent krijgt via MCP een echte browser en toegang tot je tests, zodat hij kan schrijven, debuggen en bewijzen wat werkt. Dit hebben we eerder in een team geïntroduceerd en overgedragen.
Governance vastleggen
Voorstel-gestuurd werken: de agent detecteert en stelt voor, een mens keurt elke schrijfactie goed. Allowlists voor wat hij mag aanraken. En de harde grens: geen autonome destructieve acties in een pijplijn. Op papier, en technisch afgedwongen.
Bewijs per wijziging
Reproduceerbaar bewijs per work item, gekoppeld aan je tickets: wat is getest, hoe, met welk resultaat. Bruikbaar bij een audit en bij een releasebesluit, in dezelfde structuur ongeacht wie of wat de test schreef.
Overdracht
Een deck, een script en werkafspraken, zodat het team er zelf mee verder kan. Daarna optioneel coaching per maand, of doorstromen naar een groter traject.
Wat het oplevert
Sneller tests en bewijs, met controle die security accepteert.
Agent die tests schrijft en bewijst via een echte browser
Goedkeuring per schrijfactie, harde grenzen in de pijplijn
Bewijs per work item, gekoppeld aan tickets
Team dat het zelf voortzet, met deck en werkafspraken
Wat het kost
Een pilot met een vast bedrag.
Op aanvraag
Vast bedrag, afhankelijk van de omvang van je testlandschap en het aantal mensen dat meedoet.
€ 1.950 per maand
Wekelijks sparren, meelezen op wat de agent voorstelt, governance bijsturen als je landschap verandert.
- Alle bedragen exclusief btw.
- Wij werken in jouw omgeving met jouw accounts. Er gaat geen code of data van jou naar buiten.
- Voorwaarde is dat er al een testbasis staat, of dat we die eerst inrichten.
Veelgestelde vragen
Wat klanten meestal eerst willen weten.
Wat is MCP?
Een open standaard waarmee een AI-agent gereedschap kan gebruiken: een browser, je testframework, je ticketsysteem. Zonder MCP kan een agent alleen tekst produceren. Met MCP kan hij kijken, klikken en controleren, en dat maakt het verschil tussen een gok en een bewijs.
Vervangt dit onze testers?
Nee. Het verandert wat ze doen. Minder tijd aan het uittikken van tests, meer aan bepalen wat getest moet worden en beoordelen wat de agent voorstelt. De mens blijft degene die goedkeurt.
Hoe zit het met veiligheid en onze data?
De agent werkt in jouw omgeving met jouw toegang, met allowlists voor wat hij mag aanraken, en met de harde regel dat hij nooit zelfstandig iets destructiefs doet. Precies die afspraken leggen we vast en dwingen we technisch af. Daar haken security en QA-management meestal op af, en daarom zit daar het meeste werk.
Welke AI-modellen en tools gebruiken jullie?
Wat past bij jouw omgeving en jouw beleid. We hebben eigen MCP-servers gebouwd en werken met MCP-Playwright voor de browser. Het model kiezen we samen, ook als dat een model is dat binnen je eigen muren draait.
Begin met een pilot van twee tot drie weken.
In jouw omgeving, op jouw software, met afspraken waar security mee kan leven. Aan het einde weet je wat het oplevert en wat het kost om door te gaan.